Ncワード編【Vol.1】
こちらでも、自作ソフトを公開していますが、ほとんどC++Builderで開発しています。

ライブラリも独学なので、動作はしていますが、自分で見直しても綺麗なコードではないです
こちらも、AIに頼んで見直してもらえば、綺麗になると思いますが、いろんな関数がからみあってて、あまりに量が多いです
python学習もかねて、pythonに置き換えてみようと思っています
テーマとして、NC用ライブラリのpython化を、無料版Claudeでバイブコーディングを始めました
生産性を意識する企業の場合は、Claude Codeが定番なのでしょうが、プログラム言語の学習もかねてAIを利用する場合では、逆にこちらがいい先生になるような気もしてます
まずは、NCデータを分解・解析するライブラリを複数回に分けて、記事にする予定です
pythonだけでなく、NC言語の説明もしています
NCデータ分析ライブラリ、構造
NC言語の基本
NCデータを分析するには、ある程度、NCデータ構造の理解は必要だと思います
コーディングだけなら、言語は知らなくても、AIがコーディングしてくれると思いますが、
実際の利用を考えるなら、基本的な理解はしておいたほうがいいと思います
NC言語の基本はこのサイトでも、記事にしているので、興味ある方は覗いてみてください
ライブラリ構成
今回は、C++Builderからの移行と共に、python学習も目的なので、
ライブラリ設計はAIに丸投げせず、Claudeに既存のライブラリを添付して、python化をお願いし、コードの意味を説明してもらいながら進めます
出力されたコードは、三項演算子やリスト内包表記など、python特有な書き方の場合もあります
今までだったら、参考書開いたり、ネットで検索していましたが、AIは疑問点を聞けばかなり詳細に教えてくれるので、とても便利です
まずは、下記3つのライブラリを作成します
- 「NCワード構文解析」:NCワードをアドレスと数字:数値に分解する
- 「NCコメントを分解」:NCブロックの純粋なコード部分とコメントに分割
- 「NCブロックを分解・解析」:純粋なNCコードを、「NCワード」に分解し、行の状態(位置座標など)保存・取り出し
NCワード構文解析「NcWordParser」
NCブロックの構造
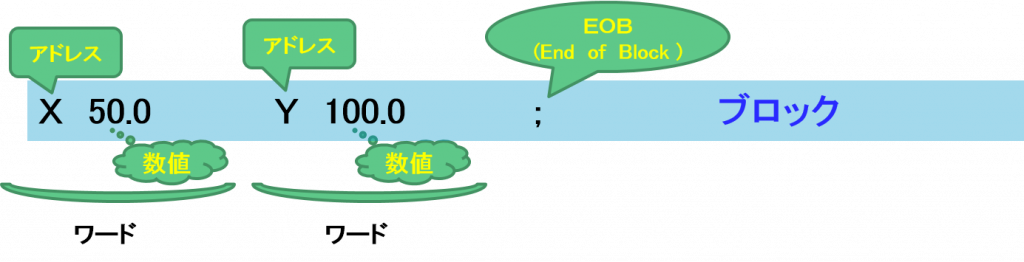
「NCブロック」は「NCワード」の集まり
「NCワード」は「アドレス(英文字)」と「数字(数値)」で構成されている
NcWordデータクラス:「Class NcWord」
NCワードの変数を格納するクラスを定義します
NCワードとしては、データクラスで定義したいを思います
4つの変数、
「ワード全体」「アドレス」「数値・数字」「Gコード場合、グループ番号」で構成します
@dataclass
class NcWord:
    word: str = ""  # 元の文字列
    address: str = ""
    value: str = ""
    group: int = -1
NCワードパーサー(構造分割):「class NcWordParser:」
NCワード文字列を受け取り、「NcWord」データクラスに分割格納します
分割するには、AIは正規表現を教えてくれましたが、NC言語構造には例外もあります
通常は「アドレス(英大文字一文字)」+「数値・数字」ですが、特殊な表現が存在します
例えば、「G04X10.」の指令・・・10秒のドウェル指令です
これを、「G04」「X10.」と分解すると、「X軸10mm移動」と誤認識する事になりかねません
他にもあるかもしれませんが、とりあえず思いあたるものは、こんな感じでしょうか?
G05P****
G54.1P**
M98P****
M198P****
G65P****
G66P****
G04X****
G04P****
この場合、どこまでをアドレスとして扱うか?
意見は分かれるところだと思いますが、筆者は上記の英数文字部分(****以外)をアドレスにすることにしました
このような判断は、AIに勝手に任せると、後々理解が大変になりそうです
やはり、作者の意図をよく伝えて、今のうちからコードに反映させておくのが大事だと思います
G_CODE_RE = re.compile(r"G0?5P|G54\.1P|M1?98P|G65P|G66P|G0?4[XP]|[A-Z]")

def get_NcWord(self, word: str) -> NcWord:
    match = self.G_CODE_RE.search(word)
    address: str = match.group(0) if match else ""
    value: str = word.replace(address, "")
    nc_word = NcWord(
        word=word,
        address=address,
        value=value,
    )
正規表現で上記の特殊表現と英文字をアドレスと取り出し、アドレス以外を数字として「NcWord」に格納します
さらに、面倒くさいのが、モーダルという概念と、Gコードのグループ分けです
NCワード単体では判断はできませんが、一行のNCブロックには、同じグループのGコードはNGです
また同じグループ番号の場合違うグループ番号が来るまでそのGコードは維持されます。
したがって、NcWordデータクラスにはグループ番号も持たせておこうと思います
このような、データ構造設計も、作者の考えで違いが出てきます
この機能を、AIに聞きながらコード化していきます
まずは、Gグループを辞書でデーター化しておきます
G_GROUPS = {
    "GROUP00": {4, 5, 7, 8, 9, 10, 27, 28, 29, 30, 31, 52, 53, 60, 65, 92},
    "GROUP01": {0, 1, 2, 3},
    "GROUP02": {17, 18, 19},
    "GROUP03": {90, 91},
    "GROUP06": {20, 21, 70, 71},
    "GROUP07": {40, 41, 42},
    "GROUP08": {43, 44, 49},
    "GROUP09": {73, 74, 76, 80, 81, 82, 83, 84, 85, 86, 87, 88, 89},
    "GROUP10": {98, 99},
    "GROUP12": {65, 66, 67},
    "GROUP14": {54, 55, 56, 57, 58, 59},
    "GROUP16": {68, 69},
}
この「G_GROUPS」をもとに、「NcWord」の「group」にグループ番号を入力します
def get_group(self, word: NcWord) -> None:
    """word:NcWord に解析したgroupを設定"""
    # _ は一つ目の返り値を無視する意味。
    # _analyzeの返り値は、tuple[str, int]
    _, group_number = self._analyze(word.address, word.value)
    word.group = group_number

def _analyze(self, address: str, number: str) -> tuple[str, int]:
    group_number = -1
    group_name = ""

    match = re.search(r"(G)(0?4|54|65|66)", address)
    if match:  # G04X10. / G54.1P1 / G65P9613 対応
        address = match.group(1)
        number = match.group(2)
    if address != "G":
        return group_name, group_number
    for n, v in self.G_GROUPS.items():
        if int(number) in v:
            group_number = int(n.replace("GROUP", ""))
            group_name = n
            break
    return group_name, group_number
NCワードクラス
実際の、コード「nc_word.py」を添付します
import re
from dataclasses import dataclass
from typing import Optional


@dataclass
class NcWord:
    word: str = ""  # 元の文字列
    address: str = ""
    value: str = ""
    group: int = -1


class NcWordParser:
    G_CODE_RE = re.compile(r"G0?5P|G54\.1P|M1?98P|G65P|G66P|G0?4[XP]|[A-Z]")

    def get_NcWord(self, word: str) -> NcWord:  # -> Optional[NcWord]:
        # if not word:
        #    return None
        match = self.G_CODE_RE.search(word)
        address: str = match.group(0) if match else ""
        value: str = word.replace(address, "")
        nc_word = NcWord(
            word=word,
            address=address,
            value=value,
        )
        GroupAnalyzer(nc_word)
        return nc_word


class GroupAnalyzer:
    """NCワード文字列のGコードからGグループを解析"""

    G_GROUPS = {
        "GROUP00": {4, 5, 7, 8, 9, 10, 27, 28, 29, 30, 31, 52, 53, 60, 65, 92},
        "GROUP01": {0, 1, 2, 3},
        "GROUP02": {17, 18, 19},
        "GROUP03": {90, 91},
        "GROUP06": {20, 21, 70, 71},
        "GROUP07": {40, 41, 42},
        "GROUP08": {43, 44, 49},
        "GROUP09": {73, 74, 76, 80, 81, 82, 83, 84, 85, 86, 87, 88, 89},
        "GROUP10": {98, 99},
        "GROUP12": {65, 66, 67},
        "GROUP14": {54, 55, 56, 57, 58, 59},
        "GROUP16": {68, 69},
    }

    def __init__(self, nc_word: Optional[NcWord] = None) -> None:
        if nc_word:
            self.get_group(nc_word)

    def get_group(self, word: NcWord) -> None:
        """word:NcWord に解析したgroupを設定"""
        # _ は一つ目の返り値を無視する意味。
        # _analyzeの返り値は、tuple[str, int]
        _, group_number = self._analyze(word.address, word.value)
        word.group = group_number

    def _analyze(self, address: str, number: str) -> tuple[str, int]:
        group_number = -1
        group_name = ""

        match = re.search(r"(G)(0?4|54|65|66)", address)
        if match:  # G04X10. / G54.1P1 / G65P9613 対応
            address = match.group(1)
            number = match.group(2)
        if address != "G":
            return group_name, group_number
        for n, v in self.G_GROUPS.items():
            if int(number) in v:
                # group_number = int(util.extract_numbers(n, 2))
                group_number = int(n.replace("GROUP", ""))
                group_name = n
                break
        return group_name, group_number


# test code
if __name__ == "__main__":
    gcode = ["G54", "G00", "G17", "G54.1P5", "G01", "G04X10.", "X20.325"]
    print("「実行結果」")
    for word in gcode:
        ncw: NcWord = NcWordParser().get_NcWord(word)
        print(ncw)
取り込んだ、NCワードデータを、アドレスと数字に分解し、アドレスが ”G”の場合、Gコードグループ番号を「NcWord」にセットします。
テストコード(test code)をライブラリ末尾に付加して実行してみます
python nc_word.py

「実行結果」
NcWord(word='G54', address='G', value='54', group=14)
NcWord(word='G00', address='G', value='00', group=1)
NcWord(word='G17', address='G', value='17', group=2)
NcWord(word='G54.1P5', address='G54.1P', value='5', group=14)
NcWord(word='G01', address='G', value='01', group=1)
NcWord(word='G04X10.', address='G04X', value='10.', group=0)
NcWord(word='X20.325', address='X', value='20.325', group=-1)
希望通り、渡したNCワード文字列から、NcWordクラスのフィールドに格納されました
コメント